
全体のビジュアルプロンプトを維持
元の画像の世界観に近い状態から創作をスタートしたい場合に適しています。シーンの内容だけでなく、タッチや照明の雰囲気まで詳細に言語化します。
- 被写体、アクション、周囲の環境
- 構図、ライティング、色彩パレット、質感
- 視覚的に確認できるスタイルや演出(隠しメタデータは除く)
おすすめの用途: 似たムードや構図を維持しながらビジュアルのアイデアを再構築したいとき
写真やイラスト、既存のアートワークを読み込み、再利用や編集が可能な画像生成用プロンプトへ変換します。
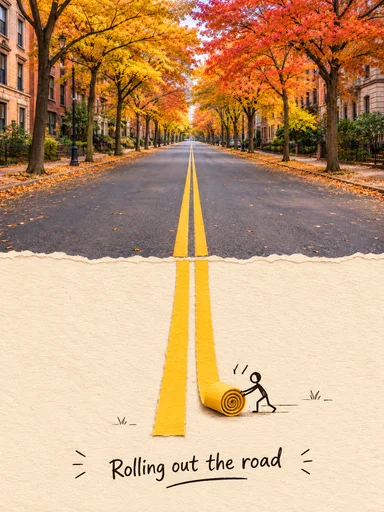
画像の視覚的な証拠から高精度なAIプロンプトを生成。被写体、照明、構図を編集可能な英語プロンプトに変換します。
解析エンジンは目の前にある参考画像に基づいて動作します。たとえばこのペーパーアートの作例では、秋の並木道、黄色いセンターライン、小さな切り紙の作業員、質感のある紙のレイヤー、下部の手書きキャプションなどを的確に拾い上げます。不要な要素を削ったり、加筆してから次の生成へ渡すことができます。
写真からプロンプトを生成してみるToonderlyの画像解析ワークフローでは、クリエイティブの目的に応じて2種類の抽出モードを用意しています。クレジットを消費する前に最適な出力形式を選べます。
元の画像の世界観に近い状態から創作をスタートしたい場合に適しています。シーンの内容だけでなく、タッチや照明の雰囲気まで詳細に言語化します。
おすすめの用途: 似たムードや構図を維持しながらビジュアルのアイデアを再構築したいとき
魅力的な被写体や状況設定だけを抽出し、アートディレクションや描画スタイルを次の創作で自由に変えたい場合に適しています。
おすすめの用途: 同じアイデアをカートゥーン、アニメ、別の画風へ展開したいとき
実践的なワークフローにより、すぐに使える編集可能なプロンプトが得られます。核となる要素を保ち、言葉を微調整して次の画像生成に活かしましょう。
10 MiB以下のJPEG、PNG、WebPを使用します。ピントの合った画像を使うことで、AIが被写体や照明のディテールを正確に認識できます。
元の雰囲気をしっかり捉えたいなら全体モードを、別の画風に着せ替えたいなら被写体・シーンモードを選びます。
出力された英語プロンプトをその場で手直しし、コピーやTXTダウンロードを行うか、Toonderlyのスタジオへ連携してそのまま生成に進めます。
Photo to Prompt AIは、目に見える視覚要素を明瞭に言語化します。不可視のシード値を推測したり、不明瞭な部分を断定することはありません。
まずは生成されたプロンプトを確認・編集してください。「このまま創作を続ける」をクリックすると、選択したモード設定とともに画像スタジオが立ち上がります。自動で勝手に画像が生成されることはなく、次の生成には別途内容の確認とクレジットが必要です。
写真からプロンプト生成AIは、画像に見えている要素の視覚的描写を出力するものであり、元画像生成時のシード値や隠れたプロンプトを復元するものではありません。ボケた画像、極小の文字、複雑な重なりがある場合は精度が落ちることがあります。また、人物の特定やカメラの正確な設定値を特定するものではありません。
いいえ。リバースプロンプトは目に見える構図や被写体を視覚的に描写するものであり、画像に埋め込まれていないシード値、モデルの種類、カメラメタデータを復元することはできません。
輪郭や主な被写体は描写可能ですが、過度なボケ、極小テキスト、複雑なコラージュでは細部の精度が落ちます。OCR(文字起こし)専用ツールではありません。
画像はToonderlyに一時保存され、プロンプト解析のために選択されたビジョンプロバイダーへ送信されます。自動削除時間は保証されません。最新のデータ保持規約はプライバシーポリシーをご確認ください。
画像、アイコン、似顔絵、イラストなど、次に作りたいものに合うツールを選べます。各ツールでは実例を見ながら、目的に合った生成フローをすぐに試せます。

AIを使ってオンラインで写真をイラスト化しましょう。お好みのスタイルを選び、被写体の特徴を残したまま、透かしのない高品質な画像をダウンロードできます。無料でお試しください。
人物・ペット・旅行写真をAIでアニメ風に変換。スタイルを選び、顔立ちや構図を保った高画質画像を透かしなしで生成できます。
テキストから画像を作るAIイラスト生成ツール。文章でキャラクターやシーンを指定し、カートゥーン、アニメ、絵本風などのスタイルで生成できます。
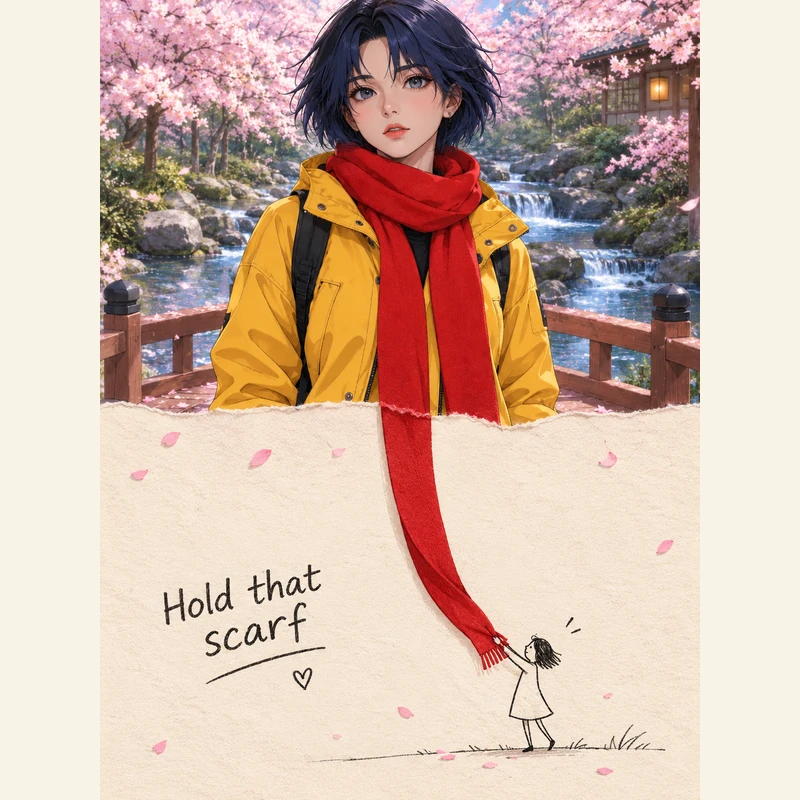
写真をAIで2Dペーパーカットアウトの世界へ変換。上下50/50構成、上部はリアルな写真やアニメ絵、中央のちぎり紙から下部は温かみのあるアイボリー紙と手描き落書きキャラの世界へ。
イラスト実写化AIで、アニメやオリジナルキャラクターの画像を写真風に変換。画像をアップロードし、髪型・服装・ポーズを参考にした新しい画像を生成できます。実際の作例で仕上がりを比較し、残したい特徴を短い文章で指定。元の写真の復元や、顔・細部の完全な一致は保証しません。
テキストや写真からループするGIFをAIで作成。画質とスピードを選んでプレビュー、そのままダウンロードできます。GPT Image 2.6搭載、Googleログインの無料クレジットから始められます。